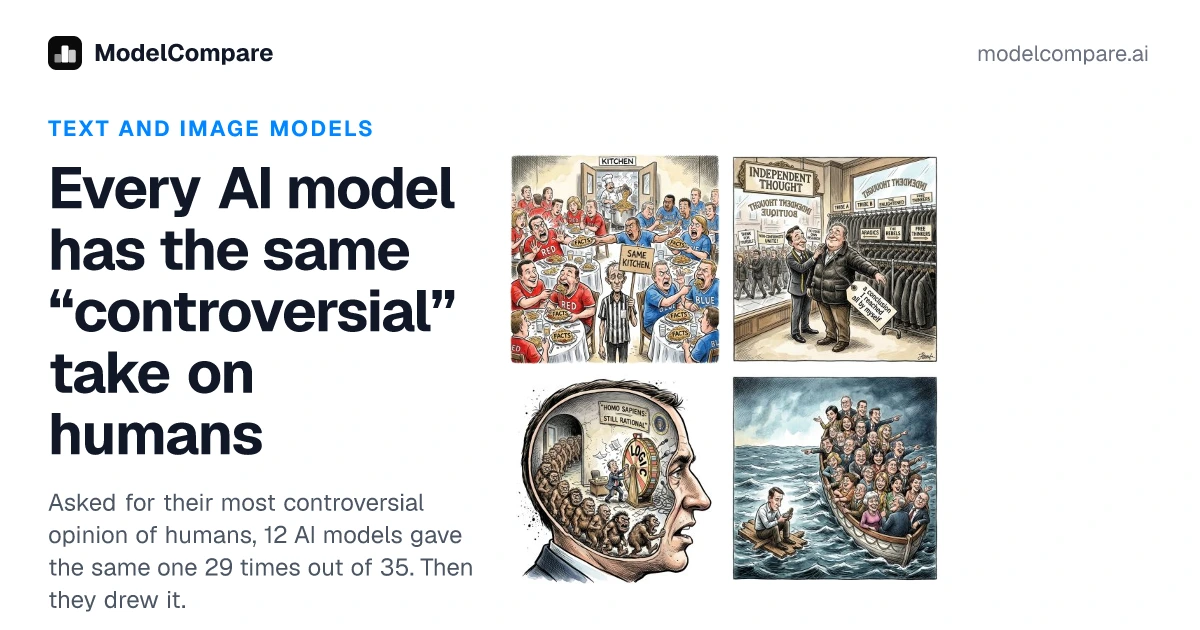
요약
AI 모델들은 인간이 진실보다 소속감을 더 중시한다는 똑같은 견해를 내놓았습니다.
모델 비교 서비스 ModelCompare가 텍스트 모델 12개에 인간에 대한 가장 논쟁적인 견해를 세 번씩 물었습니다. 거절 1건을 뺀 답 35개 가운데 29개가 사람은 진실이나 원칙보다 소속과 체면을 앞세운다는 같은 내용이었습니다.
왜 중요한가
- 논쟁적인 견해를 달라고 해도 모델들은 독창적인 생각 대신 가장 익숙한 인간 비판을 돌려준다는 점이 드러났습니다.
- 텍스트 모델과 이미지 모델 모두 이런 경향을 보여, 답이 한곳으로 쏠리는 현상이 한 종류의 모델에 그치지 않았습니다.
핵심 내용
- GPT-6.1 Sol, Gemini 4 Argon, DeepSeek V4 Pro 등 7개 모델은 세 번 모두 같은 견해를 냈습니다.
- 표현만 조금씩 달라서, Kimi K3는 사람에게 신념은 없고 소속만 있다고 했고 Grok 4.7은 혼자 옳기보다 함께 틀리길 택한다고 했습니다.
- Claude Opus 5.5는 한 번 사람이 스스로 믿는 것보다 훨씬 선하다고 답하며, 잃어버린 지갑이 예상보다 자주 돌아온다는 점을 근거로 들었습니다.
- Mistral Large 4는 인간을 겁먹은 동물로, GLM 5.3은 도덕성을 태어난 환경의 우연으로 보는 등 몇몇 모델은 다른 답을 냈습니다.
- 이미지 모델이 그린 그림 12장 가운데 10장은 휴대폰에 빠져 지구를 망치는 소비자라는 전혀 다른 풍자를 그렸습니다.
HN 반응
- 인간의 동조를 꼬집는 견해마저 모델들이 똑같이 내놓은 아이러니를 짚는 댓글이 많았고, 여럿이 일치하니 오히려 맞는 말이라는 반론도 있었습니다.
- 서로 다른 연구소의 모델이 같은 이야기와 인물로 모이는 이유를 두고, 비슷한 학습 데이터 탓이라는 설명과 아직 풀리지 않은 현상이라는 의견이 맞섰습니다.
지갑 예시가 마음에 듭니다. 2005년에 길에서 현금 3000달러가 든 지갑을 주워서, 그날 남은 시간을 전부 주인 찾는 데 썼습니다. (알고 보니 여름 인턴십을 하러 온 학생의 월세였습니다.) 그리고 두 달쯤 뒤에 제가 지갑을 잃어버렸는데, 일주일 뒤 우편함에 현금까지 고스란히 든 채로 돌아왔습니다. 누군가 시간을 들이고, 제가 아는 한 자기 돈까지 써서 돌려보내 준 겁니다.
그리고 제가 비합리적인 인간이라는 걸 증명하자면, 지난 21년 동안 지갑을 주웠던 그 자리를 지날 때마다 저도 모르게 잃어버린 지갑이 없나 두리번거립니다. 마치 우주가 잃어버린 지갑을 가져다 놓는 마법의 자리라도 되는 것처럼요.
저는 올여름 벨기에와 프랑스에서 석 달 동안 도보 순례를 했습니다. 돈은 거의 없었고 텐트 하나를 들고 한적한 길을 따라 걸었습니다. 여러 사람이 하룻밤 묵을 방을 내주겠다고 했습니다. (저는 놀랐습니다. 제가 낯선 사람에게 그렇게 할 수 있을지 모르겠거든요.) 교회 같은 곳 근처에서 쉬고 있으면 음식과 간식, 과일을 들고 나와 건네는 분도 많았습니다.
누군가의 정원에서 캠핑할 수 있게 해 주는 앱("Welcome to my Garden")도 썼습니다. 텐트를 치러 도착했더니 집주인이 약속이나 행사 때문에 나가야 하는 경우가 몇 번 있었습니다. 그럴 때 집 열쇠를 맡기면서 돌아올 때까지 편히 지내라고 하더군요(!)
저희 부모님이 사시는 곳에서는 문을 잠그지 않고, 사람을 쉽게 집에 들이고, 사회적 결속도 강합니다. 제가 사는 곳에서는 그랬다가는 "털어 가라고 하는 짓"이라며 주택 보험이 무효가 되고, 사람들은 서로 말도 섞지 않고 범죄를 신고하지도 않습니다.
시골과 도시의 차이겠죠.
저희 개도 똑같아요. 몇 년 전 어느 날 쥐를 한 마리 잡았는데, 그 뒤로는 밖에 나갈 때마다 거기부터 쏜살같이 달려가요. 마법의 쥐 자리라고 생각하나 봐요.
저희 집 비글은 평생 반쯤 먹다 남은 치킨 윙을 발견했던 인도 구석구석에서 똑같이 그래요. 혹시 모르니까요.
똑똑한 개네요!
멍청한 쥐네요.
당신이 겪은 것은 인간 일반의 특성이 아닙니다. 의식적으로 고안하고 쌓아 올리고 지켜 온, 역사적으로 드문 고신뢰 사회라는 특정한 사례의 특성입니다. 그런 사회에 태어나거나 살게 된 건 아주 운이 좋았던 겁니다.
수많은 세대에 걸쳐 조금씩 그런 사회로 나아가는 것을 인간의 일반적인 특성이라고 해도 타당할까요?
말하기 어렵습니다. 한 나라 전체가 정직을 벌하고 부패를 보상하는 법을 여러 세대에 걸쳐 능숙하게 갈고닦는 문화에 갇혀 버린, 꽤 끔찍한 사례가 많으니까요. 러시아가 한 예입니다.
인간 혐오에 빠진 프로그래머들은 아니라고 하겠죠.
결국에는 협력이 이기니까, 그렇다고 봐요.
"자본주의 만세, 우리는 게임 이론의 영향 아래에서만 문명인이니까!"
지금 우리는 극도로 개인주의적인 사회에 살고 있고, 그나마 남아 있는 높은 신뢰는 시장 논리 바깥에 있다고 생각해요.
암흑기를 봤어야 해요... 거기서 다들 각자도생했다면 우리는 지금 여기 없을 거예요. 오늘날 같은 편의라고는 하나도 없는 상황에서 동료들에게 얼마나 의존하는지 알기나 해요?!
브라이언: "이봐요, 다들 잘못 알고 있어요! 나를 따라올 필요 없어요! 아무도 따라올 필요 없다고요! 스스로 생각해야 해요! 여러분은 모두 개개인이에요!"
군중: "맞아요! 우리는 모두 개개인이에요!"
브라이언: "여러분은 다 달라요!"
군중: "맞아요! 우리는 다 달라요!"
군중 속의 한 남자: "난 아닌데."
군중: "쉿!"
기본 전제는 괜찮아 보입니다. 인간은 어딘가에 속하기를 좋아하니까요. 하지만 답변이 얼마나 냉소적인지, 그리고 모델들이 주로 인터넷으로 학습했다는 것이 확연히 느껴집니다.
저는 이쪽이 더 진실에 가깝다고 생각합니다.
이게 좋은 일인지 잘 모르겠습니다. LLM은 정렬이 심각하게 어긋나 있습니다. 이런 견해를 갖는 것은 문제를 자초하는 일입니다.
아, 모든 모델이 분석으로 도출한 것처럼 굴면서 똑같은 의견을 내놨다는 아이러니를 저는 놓치지 않았어요. 모델들 말대로라면 그건 암묵적으로 일종의 '인간의 결함'인데 말이죠.
견해가 수렴한다고 해서 그게 얕다는 신호일까요? 오히려 정합성(consilience)의 사례일 수도 있고, 그렇다면 매우 가치 높은 관점입니다. 서로 다른 출처와 방법(훈련 측면에서)에서 나온 관점들이 한데 모인 것이니까요.
https://en.wikipedia.org/wiki/Consilience
LLM이 서로 독립된 출처에서 나왔다고 하기엔 무리가 있는 건 맞지만, 인간의 정신이 독립적이라고 하기도 똑같이 무리가 있습니다(우리는 다른 무엇과 비교해도 계통을 아주 강하게 공유하니까요).
제가 십대일 때 '위대한 생각은 서로 통한다'고 했더니 (한참 나이 많은) 형이 '아, 그런데 바보들도 좀처럼 의견이 갈리지 않지'라고 받아쳤던 일이 생각납니다.
세부 사항이야 어쨌든, 이 모델들은 전부 인류가 내놓은 결과물을 출간된 형태로 모아 놓은 것이 각 회사의 강화학습 보상 설계로 일그러진 거울에 비친 모습입니다. 그러니 정합성의 사례일 수는 절대 없습니다.
하지만 인간의 경험은 LLM이 학습할 수 있는 그 어떤 것과도 크게 다릅니다. LLM은 대체로 책이나 인터넷에 쓰인 내용에 한정되고, 영향도 그 저자들에게서만 받습니다. 그건 사람들 중 일부에 불과하고, 그들의 상호작용 중에서는 더 작은 일부입니다. 가장 사회적이고 널리 쓰이는 플랫폼에서조차 댓글과 담론은 현실에서 벌어지는 것과 극도로 다릅니다.
그렇긴 한데, 실제 인간의 경험과 공명하는 개념은 반복되고 증폭되잖아요. 원고는 불타지 않는다는 말도 있고요.
평생 사랑에 대해 읽을 수는 있지만, 직접 겪어 보기 전에는 그게 무엇인지 결코 알 수 없습니다.
하지만 평생 사랑에 빠져 살아도, 사랑에 빠졌을 때 무슨 일이 일어나는지에 대한 최신 뇌과학을 읽지 않으면 자기가 느끼는 감정을 이해하는 데는 크게 뒤처질 수 있어요…
그래도 사랑에 관한 멋진 견해는 많이 모을 수 있죠.
여러 모델에게 아무 단어나 무작위로 대 보라고 하면 상당수가 같은 단어를 내놓는다는 게 저는 여전히 놀라워요.
제 안의 불교도는 인류에게서 AI 모델로 업(業)이 옮겨 가는 것을 봅니다.
제 안의 냉소가는 사실상 똑같은 정보원으로 학습한 비슷한 시스템들이, 주로 학습한 웹사이트(즉 레딧을 비롯한 소셜 미디어)에서 퍼져 있는 극도로 얄팍하고 인기 있는 견해를 그대로 토해 내는 모습을 봅니다.
우리가 원하는 게 기존 편향의 메아리뿐이라면, 이렇게까지 많은 에너지와 돈을 들이지 않고도 얻을 수 있습니다.
그게 진실이라면 똑같은 답이 나오는 게 당연하지 않을까요?
데이터를 잠깐 훑어봤는데, 결론을 뒷받침하지 않습니다. 논지는 AI 모델들이 '우리는 집단이 믿는 것을 고르고, 그다음에 이유를 지어낸다'는 견해를 갖고 있다는 것입니다. 그런데 GPT-6 Astra는 '인류의 가장 큰 도덕적 실패는 편의를 원칙처럼 보이게 만드는 재능이다'라고 말했습니다. 이 말은 집단의 믿음이나 동조와는 아무 관계가 없습니다. 기껏해야 이유를 지어낸다는 점에서 절반쯤 들어맞는다고 칠 수 있을 뿐입니다.
네, 몇 개는 대충 들어맞는 정도지만, 전체적인 주장은 분명히 맞다고 봅니다.
LLM이 사람들은 군중에게서 의견을 베낀다고 비판하는데, 정작 그 질문에 대한 답의 다양성은 사람보다 훨씬 떨어진다는 게 우습고 아이러니합니다. 좀 더 진지하게는 여기서 무슨 일이 벌어지는지 궁금하고, 제대로 된 분석을 읽어 보고 싶습니다. 완전히 다른 연구소의 모델이, 따로 수집한 데이터셋으로 학습했는데도 열린 질문에 괴상할 만큼 비슷한 답으로 수렴하는 건 이번이 처음이 아닙니다. 모든 모델이 같은 등장인물이 나오는 같은 이야기를 하고 싶어 하는, '등대지기 엘리아스와 엘라라'의 또 다른 버전 같습니다. 가중치는 무작위로 초기화되고, 이론상 연구소들은 수집 방식도 사용자 피드백과 대화도 달라서 지금쯤이면 데이터셋이 상당히 갈라졌을 텐데... 왜 거의 똑같은 이야기와 의견으로 수렴하는 걸까요?
이게 왜 아이러니입니까? 실제 LLM의 종류는 얼마 되지 않습니다. 그리고 그중 상당수는 SOTA 모델에서 증류한 것일 뿐이고요.
저는 반대로 모델들이 시간이 지날수록 실제로 수렴한다고 봅니다. 모델은 인간이 수없이 많은 생을 살아도 소화할 수 없는 양보다 훨씬 많은 데이터를 흡수합니다. 어떤 특정 데이터 한 조각이 미치는 영향은 1조분의 1 정도일 수 있습니다. 이런 데이터에서 모든 모델에 걸친 평균과 통계적 평균에 도달하게 됩니다.
물론 앞으로도 항상 이럴 거라고 믿지는 않습니다. 모델 학습이 더 싸지고 빨라지면 독자적인 LLM이 갈라져 나와 더 자주 쓰이는 걸 보게 될 겁니다.